
AI 把一年的晶片設計壓縮到五個月:下次再看到「AI 看病比醫師準」,先過三關
從 OpenAI 以 AI 模型輔助晶片設計的技術報告出發,整理報告裡的測試規則與限制說明,對應到解讀各種 AI 醫療能力說法前的三個檢查步驟,並列出該直接就醫或求助專業的時機。
這兩天的科技新聞,讓不少人好奇 AI 的邊界又推到了哪裡。OpenAI 於 11 月 18 日發布技術報告《Advancing chip design with OpenAI models》,說明他們如何用自家模型輔助晶片設計,對象包括自研推理晶片 Jalapeño,以及 AMD 的下一代 GPU 與 CPU。
數字先擺出來。在 AMD 旗艦 GPU 的 IP 上,模型相對於一個已經高度優化的基準設計,帶來最高 14% 的 PPA 改進。PPA 指的是效能、功耗、面積三個面向的綜合表現。OpenAI 的說法是,這相當於把大約一年的設計優化進展,壓縮到不到五個月內完成。AMD 已把部分成果納入近期送交製造的晶片設計,其他修改則放進生產設計文件,留給後續產品使用。
自研晶片的部分開始得更早。OpenAI 提到,2025 年初工程師就已經用 GPT-4o 參與 Jalapeño 的設計。這份報告估算,模型提出的修改讓向量計算單元的標準單元面積減少約 13%,矩陣計算單元減少約 10%。其中一個乘法器的重新設計,面積省下約 15%,運算延遲還從兩個時脈週期縮短到一個,而且這些優化已通過實際晶片驗證。
為了評估模型「獨立做設計」的能力,OpenAI 挑了兩款開源 RISC-V 處理器核心來測試:PicoRV32 與 Ibex。在每次運行約 11.2 萬 Token 的預算下,GPT-6.2 Astra 在兩款核心上的平均得分都最高,其中一項成績約是 GPT-6 Astra 的兩倍。整個評估覆蓋兩種設計任務、兩款核心與不同預算,合計 9881 次計分運行。
一年的進度變五個月,先看懂數字的前提
看到「最高 14%」「一年變五個月」,先別急著把結論推得太遠。這幾個數字各自帶著前提。
「最高 14%」的比較對象,是 AMD 已經高度優化過的基準設計,而且「最高」指的是範圍裡最好的那一個結果。同一份報告裡,AMD 下一代旗艦 CPU 的關鍵模組,驗證到的提升是個位數百分比。不同案例的幅度差距很大,這在技術報告裡很正常,到了新聞標題上,常常只剩最大的那個數字留下來。
「一年變五個月」則是 OpenAI 對設計時程的估算,前提是模型重寫描述電路行為的 SystemVerilog RTL 程式碼這類工作。它描述的是特定工作項目的加速,很難直接換算成整條產品線、或某位工程師的日常。
報告裡最值得你劃線的,是接近結尾那段但書
這份報告有個耐人尋味的細節。OpenAI 做了另一項測試:不再請模型優化現有處理器,只給書面規格和程式碼模板,讓模型從零設計 RISC-V 處理器核心,自己決定資料流動方式與流水線階段怎麼切。結果五款參與測試的模型,得分全都高於優化既有設計時的表現。
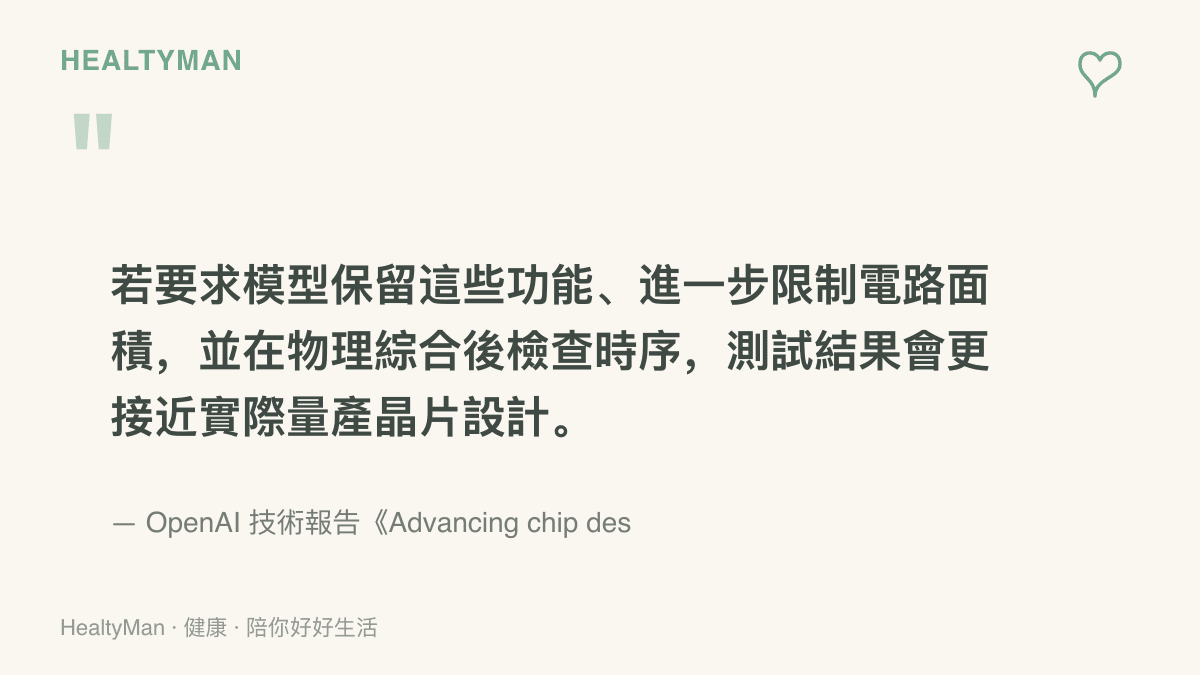
聽起來很厲害。但報告接著自己解釋:模型從零設計時,可能省略了原晶片裡的性能計數器、額外指令等功能,而這些功能對測試設定的吞吐量目標幫助有限,分數因此可能被墊高。
換句話說,連做出這些成果的一方,都花了篇幅說明成績是在特定計分規則下拿到的,規則一換,結果就會往另一個方向修正。這種把限制寫清楚的做法,在技術報告裡是基本要求。可惜訊息輾轉流傳到新聞標題、短影音字幕時,第一個被刪掉的往往就是它。
從晶片到看診間,中間還有好幾步
你可能想問,晶片設計的新聞跟健康有什麼關係。關係在於它很快就會變形。這類突破消息傳開後,長輩羣組與社羣平臺上常見的下一步推論是:AI 連晶片都會設計了,看健檢報告、判讀影像、開藥算什麼,很快輪到。
這一步推論值得慢下來。晶片設計有一個看病沒有的特性:目標可以寫成明確規格,成果可以用模擬和自動化測試反覆驗證。OpenAI 能跑 9881 次計分運行,設計沒通過正確性檢查、或面積超過原始設計的 16 倍,就直接記零分。規則清楚,分數才有得比。
你的身體沒有這種測試環境。每個人的病史、用藥、體質、生活條件都不同,醫師的問診、觸診與檢驗,很大程度上就是在取得「你這一款的規格」。這件事在晶片報告裡是現成的輸入,在診間裡得靠人一句一句問出來。這也是我們先前提過的時事可以快看,健康知識要多走一步的原因,前者看熱鬧無妨,後者套用快看公式,很容易漏掉關鍵條件。
這不代表 AI 在健康領域派不上用場。整理資料、解釋名詞、協助排列問題清單,這些輔助角色都有實際幫助。問題出在把「輔助晶片設計」直接等同「取代看診判斷」,中間省略的步驟太多了。
下次看到「AI 看病比醫師準」,先過三關
有了這份報告當範本,你可以把同樣的檢查習慣搬到健康類的新聞與傳言上。
第一關,數字跟誰比。「最高 14%」有明確基準,也老實標了「最高」二字。健康資訊裡的「風險降低三成」「改善率翻倍」同樣該這樣問:三成是相對下降還是絕對差值?舉個純算術的例子,某情況的發生率從 2% 降到 1.4%,相對下降 30%,絕對差是 0.6 個百分點。兩種講法都正確,讀起來的感受差很多。
第二關,條件像不像你。OpenAI 測的是兩款開源的 32 位元小核心、固定的 Token 預算、隱藏的測試負載。換成醫療新聞,對應的問題是:研究對象是哪個年齡層、什麼健康狀態的人?追蹤了多久?跟你自己的情況貼近嗎?條件貼近,數字對你才有參考價值;差得很遠時,那份數字留在研究者的世界裡就好。

最後一關,把但書找出來再決定要不要轉傳。這份晶片報告把最大的限制寫在接近結尾處,標題不會替你保留。健康新聞也一樣,內文後段常藏著以「然而」「僅限於」「在特定條件下」開頭的句子。轉傳給家人之前,把那幾行找出來一起看,很多乍聽驚人的說法,到這一步就現出原形。
拿 AI 問健康問題,比較穩的使用方式
如果你平常就有跟聊天機器人互動的習慣,有幾個做法可以讓它待在比較合適的位置。
回診前,把症狀日誌、用藥清單、想問的問題請它整理成條列,帶著清單進診間。看不懂的健檢項目名稱,先請它用白話解釋一輪,把有疑問的地方圈起來,下次回診問個清楚。這些用法發揮的是它擅長的整理與排版。至於「我這個症狀是什麼病」「藥要不要停」,最後一站仍然是看得到你本人、調得到你病歷的醫師與藥師。動手之前,也可以複習我們先前整理的拿健康問題問 AI 前先過四關的做法,把問題問對,比問多更重要。
這些時候,別等任何模型給答案
最後要把界線畫清楚。有些身體訊號出現時,正確的下一步是直接就醫,不是換個問法再問一次 AI。持續的胸口悶痛或壓迫感、呼吸困難、單側手腳無力或口齒不清、突然的劇烈頭痛、意識混亂、高燒合併呼吸急促,遇到這些情況,撥 119 或直接到急診。事後再跟醫師核對你查到的資料,順序永遠不嫌晚。
還有一種情況值得留意:如果你發現自己反覆用 AI 查症狀,換不同問法、越查越不安,甚至影響到睡眠,這已經超出資訊需求的範圍。跟家醫科醫師談談,或找身心科、心理師協助,都是合理的下一步,不用覺得小題大作。
慢性病的朋友請多記一條:血壓、血糖與用藥的調整,以回診和藥師諮詢為準。AI 的回答再流暢,也看不到你上一次的檢驗數值。家裡長輩若把羣組訊息或 AI 回答當成醫囑,與其在線上爭論,不如陪診時把那段話截圖帶去,讓醫療端直接幫忙判讀,通常更有效。
OpenAI 這份報告真正值得帶走的,或許不是 14% 這個數字,而是連做出成績的一方,都把適用條件寫得這麼仔細。下次讀到任何一則 AI 與健康有關的消息,把一點注意力留給數字旁邊的小字。這個小動作,會讓你比大多數只讀標題的人,更靠近事情的樣貌。
這篇文章對你有幫助嗎?
照顧身心是一段持續的旅程。想閱讀更多溫柔實用的健康內容,歡迎回到 所有文章。